
Fuite de données IA chez Cloudflare : ce que risquent vos prompts
Cloudflare reconnaît qu'un bug de son service Workers AI a exposé des fragments de requêtes de clients à d'autres clients pendant près de deux semaines. Un incident limité, mais qui pose une question directe aux entreprises : que deviennent leurs données dans une API d'IA partagée ?
 Othmane M.
Veille assistée par IA, sujets choisis, vérifiés et validés par Othmane M. Notre méthode
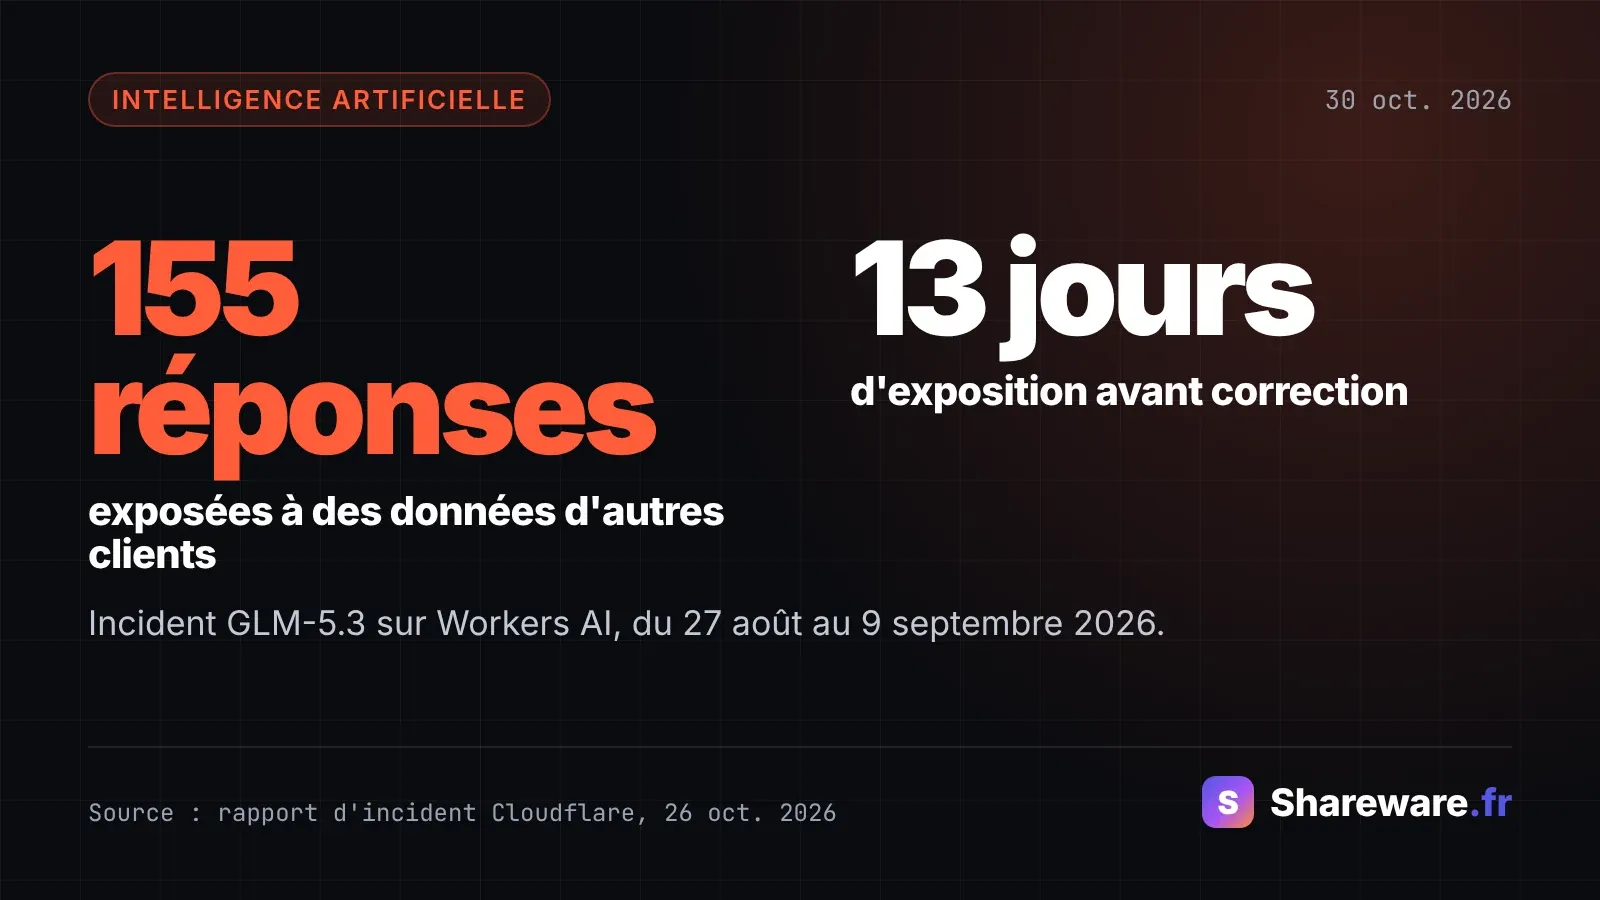
Pendant 13 jours, entre le 27 août et le 9 septembre 2026, le modèle GLM-5.3 hébergé sur Workers AI a renvoyé à certains clients des fragments de requêtes d'autres clients. Selon le rapport d'incident publié par Cloudflare le 26 octobre 2026, 155 réponses sont concernées. Le volume est faible, mais l'incident touche le point que les directions juridiques croyaient acquis : l'étanchéité entre clients d'une API d'IA mutualisée.
Que s'est il passé sur Workers AI ?
Workers AI est le service d'inférence de Cloudflare : une entreprise envoie une requête (un prompt) à un modèle hébergé, sans gérer elle même les GPU. Le 27 août 2026, Cloudflare met en ligne GLM-5.3, un modèle ouvert, avec une fenêtre de contexte de 1 048 576 tokens. Selon le rapport de Cloudflare, toutes les réponses touchées faisaient suite à des prompts de plus de 681 280 tokens, soit des documents très longs.
Le problème est signalé le 8 septembre à 23 h 11 (UTC) via la plateforme de bug bounty HackerOne. Le chercheur à l'origine du signalement est Gadi Evron, de la société Knostic, d'après Unite.AI. Cloudflare déclare l'incident le 9 septembre à 13 h 22, retire le modèle à 14 h, identifie la cause racine à 14 h 35 et le remet en service à 19 h 40.
Pourquoi des données ont elles fuité d'un client à l'autre ?
Deux défauts se sont combinés, selon Cloudflare. Le premier est une erreur de configuration : la mémoire réservée au cache KV (la mémoire de travail où le modèle conserve la représentation du texte déjà lu) ne contenait que 681 280 tokens, alors que la fenêtre annoncée en acceptait plus d'un million.
Le second est un bug du moteur d'inférence open source SGLang. Une requête trop longue aurait dû être rejetée ; elle ne l'était pas entièrement. Le nœud chargé de générer la réponse considérait que la mémoire avait été réécrite, alors que des pages contenant des données de requêtes précédentes y restaient. Le modèle lisait donc, en partie, le texte d'un autre client.
Unite.AI relève un détail qui pèse lourd : un autre utilisateur avait signalé ce comportement de SGLang dès le 6 juillet 2026, dans un ticket public. Cloudflare reconnaît aussi que ses tests vérifiaient les codes HTTP et les performances, pas la cohérence des réponses.
Quelle est l'ampleur réelle de l'exposition ?
Cloudflare évoque « a small number of customers », sans donner de nombre de clients. L'entreprise indique n'avoir trouvé « no evidence of deliberate exploitation » : les requêtes concernées ressemblent à un usage normal de contextes longs, une fois exclus ses propres tests et ceux du chercheur. Aucun autre modèle de Workers AI n'est touché, précise le rapport.
Le contenu exact des 155 réponses n'est pas décrit. C'est le point clé pour une entreprise cliente : un prompt de plusieurs centaines de milliers de tokens contient presque toujours des documents internes, des contrats, des tickets clients ou du code. S'il comportait des données personnelles, il s'agit d'une atteinte à la confidentialité au sens du RGPD, même accidentelle et limitée.
Qui doit notifier quoi, et dans quel délai ?
Lorsqu'un prestataire traite des données pour le compte d'une entreprise, le RGPD le qualifie en général de sous traitant ; l'entreprise reste responsable de traitement. La fiche de la CNIL sur les violations de données rappelle que la notification à l'autorité doit intervenir « au plus tard 72h après que le responsable du traitement en a pris connaissance », et que les sous traitants doivent « alerter l'organisme de tout incident de sécurité dans les meilleurs délais ».
Même sans notification, toute violation doit être inscrite dans un registre interne. Les personnes concernées doivent être informées lorsque le risque est élevé. La CNIL a détaillé ce partage des rôles dans un cas pratique publié le 27 mai 2026 sur le sous traitant au centre de la crise : le prestataire aide ses clients à notifier, et chaque client complète sa notification quand une atteinte à la confidentialité est confirmée.
Le rapport de Cloudflare ne décrit pas de notification directe aux clients dont les données ont été exposées. Il mentionne la divulgation coordonnée avec le chercheur et la publication du billet. Entre la correction du 9 septembre et la publication du 26 octobre, 47 jours se sont écoulés. Pour un responsable de traitement, la question pratique est donc simple : avez vous été informé, et à quelle date ?
Ce que l'incident révèle des API d'IA mutualisées
L'incident ne vise pas un modèle « défaillant » mais la couche d'infrastructure qui le sert. Les fournisseurs optimisent la mémoire des GPU en partageant des ressources entre requêtes ; c'est ce qui rend l'inférence abordable. Les contextes très longs, vendus comme un avantage commercial, augmentent la quantité de données en mémoire partagée.
Les correctifs détaillés dans le rapport de Cloudflare vont dans ce sens : un pool de cache porté à environ 2,04 millions de tokens pour couvrir toute la fenêtre de contexte, des sommes de contrôle sur les transferts de cache et, à terme, un étiquetage des pages mémoire par requête. Cloudflare recommande aux autres opérateurs de passer à SGLang 0.5.22 ou plus récent.
Pour les entreprises qui hésitent entre API mutualisée et modèle déployé chez elles, l'épisode donne un argument concret au second camp. Nous avions détaillé les arbitrages dans notre analyse sur le virage open-weight des DSI français et sur Mistral Large 4 et le choix d'un modèle souverain.
Ce que les dirigeants doivent faire maintenant
L'objectif n'est pas de couper les API d'IA, mais de traiter ces prestataires comme n'importe quel sous traitant critique. Cinq actions concrètes :
- Recenser les usages. Quels services d'inférence reçoivent des données de l'entreprise, avec quels volumes de contexte ? L'inventaire exigé par l'AI Act est un bon point de départ, comme le montrait notre article sur la cartographie des usages IA en entreprise.
- Vérifier les clauses de sous traitance. Le contrat ou l'addendum de protection des données doit fixer un délai d'alerte en cas d'incident et le contenu de l'information transmise.
- Interroger les fournisseurs. Demandez par écrit si vos requêtes ont transité par un moteur concerné et quels tests vérifient l'isolation entre clients.
- Limiter ce qui part dans les prompts. Pseudonymiser les données personnelles avant envoi et éviter d'injecter des corpus entiers quand un extrait suffit.
- Préparer la procédure. Registre des violations à jour, référent désigné, modèle de notification prêt : le délai de 72 heures court vite.
Le débat européen sur l'allègement du RGPD pour l'IA, que nous suivons dans notre article sur l'omnibus numérique, ne change rien à ces obligations de sécurité à ce stade. Cet article décrit un cadre général et ne constitue pas un conseil juridique.
Sources : Cloudflare, CNIL, Unite.AI. Article rédigé avec l'aide de l'IA selon notre [charte](https://www.shareware.fr/charte-ia).
Questions fréquentes
Quels clients de Cloudflare sont concernés par la fuite de Workers AI ?
Seuls les utilisateurs du modèle GLM-5.3 sur Workers AI ayant envoyé des prompts de plus de 681 280 tokens entre le 27 août et le 9 septembre 2026 sont concernés, selon Cloudflare. L'entreprise parle d'un petit nombre de clients sans donner de chiffre et précise qu'aucun autre modèle hébergé n'a été touché.
Une fuite chez un fournisseur d'IA doit elle être notifiée à la CNIL ?
Si les prompts exposés contenaient des données personnelles, il s'agit d'une violation de données. Le responsable de traitement, c'est à dire l'entreprise cliente en général, doit la notifier à la CNIL dans les 72 heures après en avoir pris connaissance, sauf risque improbable pour les personnes, et l'inscrire dans son registre interne dans tous les cas.
Comment réduire le risque de fuite de données dans une API d'IA ?
Les leviers principaux sont contractuels et techniques : clauses de sous traitance avec délai d'alerte, questions écrites au fournisseur sur l'isolation entre clients, pseudonymisation des données personnelles avant envoi et limitation des documents injectés dans les prompts. Pour les données les plus sensibles, un modèle déployé en interne supprime le partage d'infrastructure.